
AIクローラーとrobots.txt・llms.txt AIに自社サイトを読ませる設定のしかた
まず確認 AIのクローラーを、ブロックしていませんか?
クローラーは、サイトのページを読んで回る、自動のプログラムです。検索エンジンだけでなく、AIのサービスにも、それぞれ、クローラーがあります。
サイトの入口にある「robots.txt」というファイルで、クローラーごとに、読んでよいか、いけないかを、指示できます。
問題は、robots.txtが、意図せず、AIのクローラーを拒否していることがあることです。
セキュリティの設定や、サイト制作時の古い設定、プラグインの初期値で、「すべて拒否」になっていることがあります。
AIに、自社を知ってもらいたいのに、入口で断っている状態です。
この記事の内容は、各社が公開している情報にもとづく一般的な説明です。AIがどのページを、どう使うかは、各社が決めていて、設定をしても、紹介や引用は保証されません。
AIのクローラーの種類 目的で分けて考える
AIのクローラーは、目的によって、大きく3つに分けて考えられます。
「AIの学習に使う」「検索結果を作るために使う」「ユーザーの質問に答えるために、その場で読む」です。会社によって、クローラーの名前が分かれています。
| 名前 | 運営 | 主な目的 |
|---|---|---|
| GPTBot | OpenAI | AIの学習のためのデータ収集 |
| OAI-SearchBot | OpenAI | ChatGPTの検索機能で、サイトを見つけやすくするため |
| ChatGPT-User | OpenAI | ユーザーの質問に答えるために、その場でページを読む |
| Google-Extended | Geminiなどの学習・回答への利用を、管理するための指定 | |
| PerplexityBot | Perplexity | 検索結果に、サイトを載せるため |
| ClaudeBot など | Anthropic | AIの学習・回答のための収集(種類が複数ある) |
| bingbot | Microsoft | Bing検索のためのクローラー(Copilotなどにも関わる) |
名前や役割は、各社が変更することがあります。必ず、各社の公式ページで、最新の情報を確認してください。
ここで大切なのは、「学習に使われるのは嫌だが、検索や回答には出たい」という考え方も、できるという点です。
会社によって、クローラーが分かれているのは、そのためです。
ただし、お店や会社のサイトの場合は、むしろ、AIに正しく読んでもらいたいことが多いので、基本は、許可する方向で考えます。
robots.txtの確認と書き方
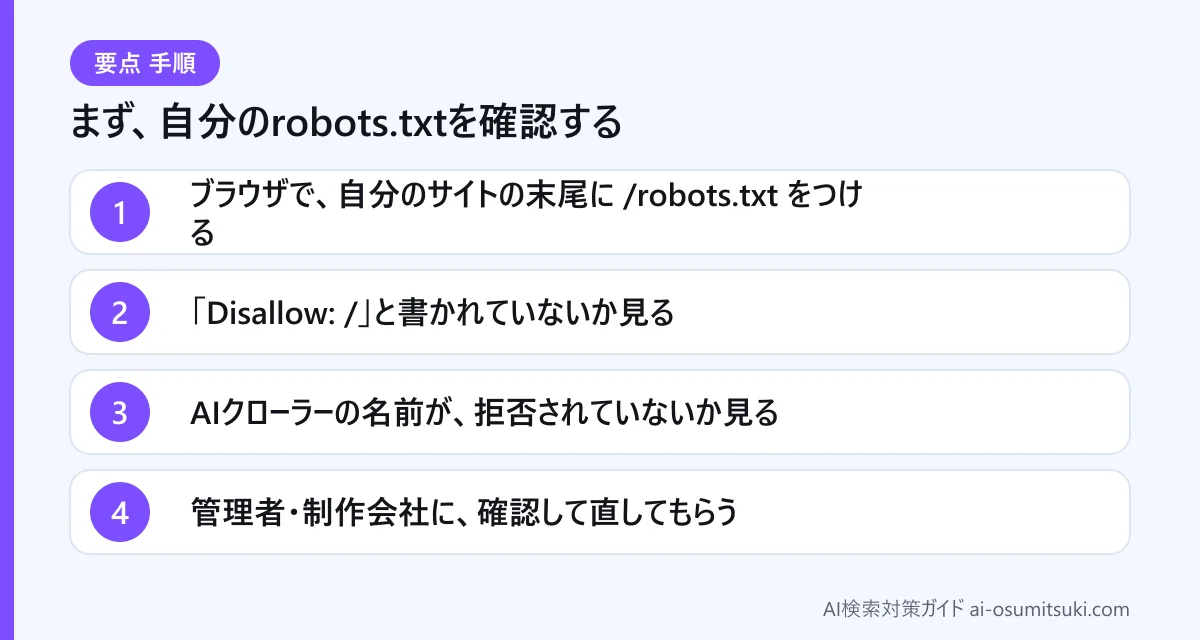
- 1ブラウザで、自分のサイトの末尾に /robots.txt をつける例: https://example.com/robots.txt
- 2「Disallow: /」と書かれていないか見るすべてを拒否する指示。意図していなければ、直す。
- 3AIクローラーの名前が、拒否されていないか見るGPTBot・OAI-SearchBot・Google-Extendedなどの名前を探す。
- 4管理者・制作会社に、確認して直してもらう自分で直せない場合は、このページの説明を渡して依頼する。
# 検索エンジンと、AIのクローラーを許可する
User-agent: *
Allow: /

User-agent: GPTBot
Allow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: ChatGPT-User
Allow: /

User-agent: Google-Extended
Allow: /

User-agent: PerplexityBot
Allow: /

# 管理画面など、見せなくてよい場所は拒否する
User-agent: *
Disallow: /admin/

Sitemap: https://example.com/sitemap.xml
管理画面・会員ページなど、公開したくない場所は、Disallowで外します。サイトマップの場所も書いておきます。
# 学習用のクローラーだけを拒否する例
User-agent: GPTBot
Disallow: /

# 検索・回答用のクローラーは許可する
User-agent: OAI-SearchBot
Allow: /
何を許可し、何を拒否するかは、お店や会社の方針で決めます。迷ったら、まず許可で、様子を見る方法もあります。
robots.txtは、あくまで「お願い」のファイルです。ルールを守るクローラーは従いますが、守らないものもあります。
本当に隠したい情報は、robots.txtではなく、会員ページやパスワードで、守る必要があります。
llms.txtとは どこまで期待してよい?
llms.txtは、AIに向けて、サイトの概要や、読んでほしいページの一覧を、テキストでまとめておく、というアイデアです。
サイトの入口に、/llms.txt というファイルを置きます。一覧や説明を、人が読んでも分かる形で書きます。
| 項目 | 現状の整理 |
|---|---|
| できること | サイトの概要・主要ページ・運営者を、AIにも分かりやすい形で、まとめておける |
| できないこと | 紹介や引用を、保証する。順位を上げる |
| 公式な位置づけ | 広く提案されている書き方で、主要なAIサービスが、必ず使うと約束したものではない |
| 置いて損があるか | 損はほとんどない。更新を忘れると、古い情報が残る点だけ注意 |
使われるかどうかは、各AIサービスの判断です。置いた場合は、内容を最新に保ちます。
当サイトでも、サイトの概要を書いた llms.txt と、記事の本文をまとめた llms-full.txt を置いています。
ただし、これらを置いたことで、AIに紹介されることを、保証できるものではありません。「置いて損はないので、置いている」というのが、正直なところです。
# ナビカフェ 広島店

> 広島市中区にある、コーヒーと焼き菓子のお店です。営業時間は、平日9:00〜18:00です。

## 主なページ
- [メニューと料金](https://example.com/menu): ドリンク・フード・セットの価格
- [アクセス](https://example.com/access): 住所・駐車場・最寄りの駅
- [よくある質問](https://example.com/faq): 予約・子連れ・アレルギー対応

## 運営
- 運営: 有限会社ナビ商店
- 連絡先: info@example.com
店名・内容は、架空の例です。事実と違うことは、書きません。
robots.txt以外に、AIに読ませるために整えること
- robots.txtで、AIのクローラーを拒否していない
- サイトマップ(sitemap.xml)を用意し、robots.txtにも書いている
- 大事な情報が、画像ではなく、テキストで書いてある
- ページの表示が重すぎない(読み込みが遅いと、読まれにくくなることがある)
- JavaScriptでしか表示されない情報に、頼りすぎていない
- 店名・住所・電話・営業時間が、マップやSNSと同じ
- 構造化データで、基本情報を機械にも伝えている
- noindex(検索に出さない指定)を、うっかり入れていない
自社サイトに貼れる構造化データ(LocalBusiness)を、入力するだけで作れます。
構造化データを無料で作るケース別の例(架空のサイト)
ケースA 制作時の「全拒否」が、残っていた工務店
サイトを作り直したとき、公開前のテスト用に、robots.txtで全体を拒否していました。
公開後も、そのまま残っていて、検索にもAIにも、読まれにくい状態でした。
Disallowの行を消し、サイトマップを書き、Search Consoleで確認したところ、数週間で、ページが読まれ始めました。
ケースB プラグインが、AIをブロックしていたクリニック
WordPressのセキュリティのプラグインが、「ボットの拒否」を、初期設定で有効にしていました。
検索エンジンは許可されていましたが、AIのクローラーが、拒否されていました。
設定を見直し、医療広告ガイドラインに配慮した、正確な診療情報だけを、読めるようにしました。
ケースC 学習は避けたい、写真家のサイト
作品の写真を、AIの学習に使われたくない写真家は、学習用のクローラーを拒否し、検索・回答用のクローラーは許可しました。
ただし、robots.txtは「お願い」にすぎないため、高解像度の作品は、サイトに載せないなどの、別の工夫も、あわせて行いました。
自社のサイトを、AIに読んでもらうかどうかは、お店や会社の方針です。まず、現状を確認し、意図しない拒否だけを、なくすことから、始めてください。
Googleなどの画面・機能の名前や仕様は、予告なく変わります。この記事は2026年10月時点の一般的な内容です。操作の前に、各サービスの公式ヘルプも確認してください。
Google・Apple・Bing・AIで自分のお店が見つかるか、無料で確認できます(登録不要)。
無料で掲載状況をチェック自分でやる時間がない・不安な方へ。登録や情報整備のサポートも行っています。
登録・修正のサポートを見る